İçindekiler
Veri gölleri, ham veriyi düşük maliyetle saklamak için harikadır; fakat klasik dosya klasörü yaklaşımı büyüdükçe yönetim kabusa dönüşebilir. Hangi Parquet dosyası güncel, silinen kayıt gerçekten silindi mi, iki farklı işlem aynı anda yazarsa ne olur? Apache Iceberg, bu sorulara modern bir tablo katmanı ekleyerek veri gölünü SQL dünyasının güvenilirliğiyle buluşturur. ``
Iceberg tam olarak nedir?
Apache Iceberg; Parquet, ORC ve Avro gibi dosya biçimlerinin üstünde çalışan, açık kaynaklı bir tablo formatıdır. Yani Iceberg bir veritabanı ya da depolama sistemi değildir. Verileriniz S3, ADLS, GCS veya HDFS üzerinde dosya olarak kalır; Iceberg ise bu dosyaların hangi mantıksal tabloya ait olduğunu, hangi sürümün geçerli olduğunu ve sorgunun hangi dosyalara gitmesi gerektiğini yönetir.
Bu yaklaşımda tablo bilgisi katmanlı metadata dosyalarında saklanır. En üstte tablo metadata dosyası, onun altında manifest listeleri ve manifest dosyaları bulunur. Manifestler; veri dosyalarının yolunu, bölüm bilgisini, satır sayılarını ve sütun istatistiklerini taşır. Sorgu motoru önce bu küçük metadata yapılarını okuyarak gereksiz büyük dosyaları elemek için çalışır.
Basitçe, taranacak veri miktarı yaklaşık olarak şöyle düşünülebilir:
\[\text{Okunan Veri} = \sum_{i=1}^{n} \text{Seçilen Dosya}_i\]Iceberg’in hedefi, filtre koşullarına göre $n$ değerini mümkün olduğunca küçültmektir. Böylece tüm gölü taramak yerine yalnızca ilgili dosyalar okunur.
Neden klasik Hive tablolarından farklıdır?
Klasik Hive tarzı tablolarda bölümleme çoğunlukla klasör adına bağlıdır: date=2026-08-10/. Şema değişiklikleri, dosya listeleri ve bölüm bilgisi çeşitli yerlerde yönetilir. Iceberg ise bölümleri metadata üzerinden takip eder; fiziksel klasör düzeni mantıksal tablo tasarımını belirlemez.
| Özellik | Klasik Hive tablosu | Apache Iceberg |
|---|---|---|
| Atomik yazma | Genellikle ek işlem gerekir | Snapshot tabanlıdır |
| Şema evrimi | Riskli veya maliyetli olabilir | Sütun kimlikleriyle güvenlidir |
| Bölümleme | Klasör yapısına bağımlıdır | Gizli bölümleme desteklenir |
| Zaman yolculuğu | Yerleşik değildir | Snapshot üzerinden yerleşiktir |
| Dosya eleme | Sınırlı olabilir | Manifest istatistikleriyle güçlüdür |
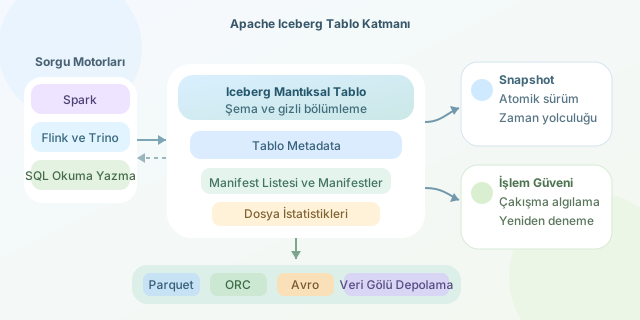
Snapshot mantığı ve ACID işlemler
Iceberg’te her başarılı INSERT, UPDATE, DELETE veya MERGE işlemi yeni bir snapshot üretir. Okuyucular işlem sırasında yarım kalmış bir dosya kümesi görmez; ya eski snapshot’ı ya da tamamen yeni snapshot’ı görür. Bu, özellikle aynı tabloya paralel Spark, Flink ve Trino işleri yazarken çok değerlidir.
Iceberg iyimser eşzamanlılık denetimi kullanır. Bir işlem mevcut metadata sürümünü temel alır, değişikliklerini hazırlar ve sonunda metadata işaretçisini atomik biçimde güncellemeye çalışır. Başka bir işlem araya girdiyse çakışma algılanır ve işlem yeniden denenebilir.
Örneğin Spark SQL ile tablo oluşturup veri eklemek oldukça doğaldır:
CREATE TABLE lakehouse.sales (
  sale_id BIGINT,
  customer_id BIGINT,
  amount DECIMAL(12, 2),
  sold_at TIMESTAMP
)
USING iceberg
PARTITIONED BY (days(sold_at));

INSERT INTO lakehouse.sales VALUES
  (101, 42, 799.90, TIMESTAMP '2026-08-10 14:30:00');
Buradaki days(sold_at) ifadesi, zaman damgasını günlük bölümlere ayırır. Sorgu yazarken kullanıcı fiziksel bölüm sütunuyla uğraşmaz; WHERE sold_at >= ... filtresi yeterlidir. Iceberg, dönüşümü metadata düzeyinde bilir.
Zaman yolculuğu ve bakım işleri
Snapshot’lar sayesinde geçmişe bakmak mümkündür. Hatalı bir veri yüklemesinden sonra önceki sürümü incelemek, denetim yapmak veya raporun hangi veri sürümüyle üretildiğini tekrar oluşturmak kolaylaşır. Ancak snapshot’lar ve küçük dosyalar sonsuza dek birikmemelidir. Üretimde düzenli olarak snapshot temizliği, orphan dosya silme ve küçük dosyaları birleştirme işlemleri planlanmalıdır.
Iceberg özellikle büyük veri gölü üzerinde güvenilir tablo semantiği isteyen ekipler için güçlüdür. Spark, Flink, Trino, Presto, Hive ve Snowflake gibi araçlarla ekosistem entegrasyonu sunar. Kısacası dosyaları sadece depolamak yerine, onları sürümlenebilir, sorgulanabilir ve yönetilebilir tablolara dönüştürür.
Yorumlar