İçindekiler
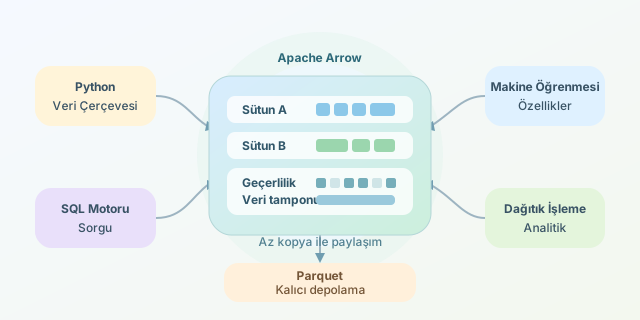
Modern veri ekiplerinde aynı tablo; Python, SQL motorları, veri gölleri ve makine öğrenmesi araçları arasında sürekli taşınır. Sorun şu ki bu araçların her biri veriyi farklı bellek düzenleriyle temsil edebilir. Apache Arrow, bu dönüşüm maliyetini azaltmak için tasarlanmış, dil bağımsız ve bellek içi sütun bazlı bir veri formatıdır. Amaç yalnızca dosya okumayı hızlandırmak değil; analitik araçların veriyi kopyalamadan veya çok az kopyalayarak paylaşabilmesini sağlamaktır. ``
Satır bazlı dünyadan sütun bazlı dünyaya
Satır bazlı bir yapıda bir kaydın tüm alanları yan yana tutulur: müşteri kimliği, şehir, tutar ve tarih gibi. İşlem tek bir kayda ait tüm bilgileri gerektiriyorsa bu düzen kullanışlıdır. Örneğin geleneksel işlem sistemleri (OLTP), bir siparişi eklerken ya da güncellerken satır bazlı depolamadan fayda görür.
Analitik sorgular ise çoğunlukla tablonun birkaç sütununu tarar. SUM(tutar) sorgusunun müşteri adresini veya sipariş notunu belleğe getirmesine gerek yoktur. Arrow, aynı sütuna ait değerleri ardışık olarak saklayarak bu davranışı verimli hâle getirir.
| Özellik | Satır bazlı düzen | Sütun bazlı Arrow düzeni |
|---|---|---|
| Güçlü olduğu iş yükü | Tek kayıt ekleme/güncelleme | Toplu tarama ve agregasyon |
| Bellek erişimi | Farklı alanlar arasında sıçrama | Aynı türden ardışık değerler |
| Sıkıştırma potansiyeli | Genellikle daha düşük | Benzer değerler nedeniyle yüksek |
| Vektörleştirme | Sınırlı | SIMD için elverişli |
Bu farkı basitçe bellek bant genişliğiyle açıklayabiliriz. Bir analiz sorgusunun yaklaşık maliyeti şu şekilde düşünülebilir:
\[T \approx \frac{B_{okunan}}{R_{bellek}} + T_{hesaplama}\]Burada $B_{okunan}$ okunan bayt miktarı, $R_{bellek}$ ise etkin bellek aktarım hızıdır. Gereksiz sütunlar okunmadığında $B_{okunan}$ küçülür; dolayısıyla sorgu süresi de çoğu durumda azalır.
Arrow’un bellek modeli neden farklıdır?
Arrow bir tabloyu RecordBatch adı verilen parçalara ayırır. Her sütun, türüne göre düzenlenmiş tamponlardan (buffer) oluşur. Örneğin nullable bir int64 sütununda tipik olarak iki temel tampon bulunur: hangi değerlerin geçerli olduğunu belirten bitmap ve sayısal değerlerin bulunduğu veri tamponu. Değişken uzunluklu metinlerde buna ek olarak başlangıç/bitiş konumlarını tutan offset tamponu yer alır.
Bu tasarımın önemli sonucu, null değerlerin her kayıt için ayrı nesnelerle temsil edilmemesidir. Geçerlilik bilgisi bit düzeyinde saklanabilir. $n$ satır için null bitmap maliyeti yaklaşık $n/8$ bayttır; bu da özellikle büyük tablolarda nesne tabanlı temsillere göre ciddi bellek avantajı sağlar.
Arrow ayrıca zero-copy paylaşımı hedefler. Yani bir araçtaki bellek tamponu, uygun koşullarda başka bir araç tarafından yeniden serileştirilmeden okunabilir. Python tarafında Pandas veya Polars, işlem motorlarında DuckDB, dağıtık dünyada Spark ve veri çerçevesi ekosistemindeki birçok araç Arrow ile entegre çalışır.
Python ile küçük bir Arrow örneği
Aşağıdaki örnek, Python listelerinden bir Arrow tablosu üretir, kolon seçer ve Parquet dosyasına yazar. Parquet kalıcı depolama formatıdır; Arrow ise özellikle bellek içi değişim biçimi olarak öne çıkar.
import pyarrow as pa
import pyarrow.parquet as pq

veri = {
    "urun": ["Klavye", "Mouse", "Monitör"],
    "adet": [12, 30, 5],
    "gelir": [8400.0, 4500.0, 17500.0]
}

tablo = pa.table(veri)
finans_kolonlari = tablo.select(["adet", "gelir"])

pq.write_table(tablo, "satislar.parquet")
print(finans_kolonlari.schema)
Burada pa.table, tip bilgilerini taşıyan sütunlu bir yapı kurar. select işlemi yalnızca ihtiyaç duyulan alanlarla çalışmayı ifade eder. Gerçek projelerde bu yaklaşım, geniş tablolarda gereksiz veri taşımayı azaltır.
Ne zaman Arrow seçilmeli?
Arrow; ETL boru hatları, veri çerçeveleri arası aktarım, büyük ölçekli analitik ve makine öğrenmesi öncesi özellik hazırlama süreçlerinde güçlüdür. Ancak sık sık tekil kayıt güncelleyen operasyonel veritabanlarının doğrudan alternatifi değildir. En iyi sonuç, Arrow’u hızlı bellek içi paylaşım katmanı; Parquet’i ise analiz odaklı kalıcı depolama katmanı olarak birlikte konumlandırmakla alınır. Kısacası Arrow, veri araçları arasındaki “çeviri masrafını” azaltarak analitik sistemlerin daha akıcı konuşmasını sağlar.
Yorumlar