İçindekiler
Oracle Cloud A1 örneklerinde çalışan Ampere Altra işlemciler, x86 sunuculardan ARM64 dünyasına geçmek isteyen geliştiricilere yüksek çekirdek sayısı ve enerji verimliliği sunar. Ancak kodu yalnızca yeniden derlemek, işlemciden tam performans almak için yeterli değildir. Bellek hizalama, veri yerleşimi ve önbellek kullanımı önemsenmezse güçlü çekirdekler zamanlarının çoğunu veriyi bekleyerek geçirebilir. ``
Önce mimariyi tanıyalım
Ampere Altra, AArch64 komut setini kullanır ve çekirdek başına tek iş parçacığı çalıştırır; yani x86 sunucularda sık görülen SMT yaklaşımına dayanmaz. Bu tasarım performansın daha öngörülebilir olmasını sağlar. Buna karşılık uygulamanın çok sayıda fiziksel çekirdeğe düzgün biçimde dağıtılması gerekir.
Bellek performansını anlamanın temelinde yerellik bulunur:
- Zamansal yerellik: Yakın zamanda kullanılan verinin yeniden kullanılma ihtimali yüksektir.
- Mekânsal yerellik: Bir adrese erişildiğinde komşu adreslere de yakında erişilmesi beklenir.
Bir veri kümesinin önbellekte kalıp kalmadığını kabaca şu oranla düşünebiliriz:
\[\text{Çalışma Kümesi Oranı} = \frac{\text{Sık kullanılan veri boyutu}}{\text{Kullanılabilir önbellek boyutu}}\]Oran büyüdükçe önbellek kaçırma olasılığı artar. İşlemci aritmetik yapabilecek durumda olsa bile RAM’den veri gelmesini bekler; performans partisinin müziği aniden yavaşlar.
x86 ve ARM64 arasında pratik farklar
| Konu | Modern x86-64 | Ampere ARM64 |
|---|---|---|
| Hizalanmamış erişim | Genellikle desteklenir, bazen pahalıdır | Normal bellekte çoğunlukla desteklenir, fakat ceza ve özel durumlar vardır |
| Bellek modeli | Daha güçlü sıralama eğilimindedir | Daha zayıf sıralama; doğru atomik ve bariyer kullanımı önemlidir |
| SIMD | SSE/AVX ailesi | 128 bit NEON/Advanced SIMD |
| İş parçacığı yapısı | SMT yaygın olabilir | Altra çekirdeklerinde SMT yoktur |
| Önbellek satırı | Çoğunlukla 64 bayt | Altra’da 64 bayt |
ARM64 hizalanmamış erişimleri tamamen yasaklamaz. Yine de bir veri iki önbellek satırına taşarsa tek mantıksal erişim iki satırın getirilmesine dönüşebilir. Atomik işlemlerde, SIMD yüklemelerinde veya bellek eşlemeli aygıt bölgelerinde daha katı kurallar da devreye girebilir.
Veriyi önbellek satırına göre hizalamak
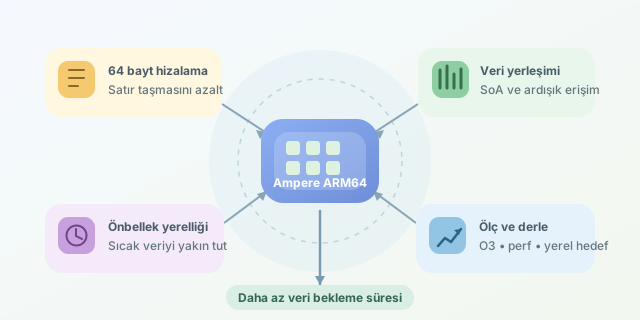
Sık güncellenen yapıları 64 bayta hizalamak, satır taşmalarını ve çekirdekler arasındaki gereksiz önbellek trafiğini azaltabilir:
#include <stdalign.h>
#include <stdint.h>

// Her sayaç ayrı bir önbellek satırında tutulur.
typedef struct {
    alignas(64) uint64_t value;
    uint8_t padding[56];
} Counter;
Bu örnekte dolgu alanı ilk bakışta israf gibi görünür. Fakat farklı çekirdeklerin güncellediği sayaçlar aynı satırda bulunursa false sharing oluşur. Değerler mantıksal olarak bağımsız olsa da önbellek tutarlılık mekanizması satırı çekirdekler arasında sürekli taşır.
Hizalamanın maliyeti yaklaşık olarak şöyledir:
\[\text{Ek Bellek} = N \times (S_{hizalı} - S_{gerçek})\]Dolayısıyla her yapıyı körü körüne 64 bayta büyütmek yerine yalnızca sıcak ve eş zamanlı güncellenen verileri ayırmak gerekir.
Veri yerleşimini iyileştirmek
Büyük nesnelerde yalnızca birkaç alan okunuyorsa Array of Structures yerine Structure of Arrays düzeni daha verimli olabilir:
// SIMD ve sıralı erişim için uygun yerleşim.
typedef struct {
    float *x;
    float *y;
    float *z;
} Positions;

float sum_x(const Positions *p, size_t count) {
    float total = 0.0f;
    for (size_t i = 0; i < count; ++i)
        total += p->x[i];
    return total;
}
Burada x değerleri ardışık tutulur. Donanımsal ön-getirici düzenli erişimi daha kolay algılar, gereksiz y ve z verileri önbelleğe taşınmaz ve derleyicinin NEON vektörleştirmesi kolaylaşır.
Derleme ve ölçüm
Ampere üzerinde GCC veya Clang ile yerel hedefleme kullanılabilir:
gcc -O3 -mcpu=neoverse-n1 -flto app.c -o app
perf stat -e cache-references,cache-misses,cycles,instructions ./app
-O3 ve -mcpu optimizasyon fırsatlarını artırır; ancak sonucu garanti etmez. perf, önbellek kaçırmalarını ve çevrim başına yapılan işi görmenizi sağlar. Son kararı tahmin değil ölçüm vermelidir: gerçek veriyle benchmark çalıştırın, NUMA yerleşimini kontrol edin ve iş parçacıklarını mümkün olduğunca yerel belleğe yakın tutun. ARM optimizasyonunun altın kuralı basittir: daha çok komut değil, daha az veri bekleme süresi!
Yorumlar