İçindekiler
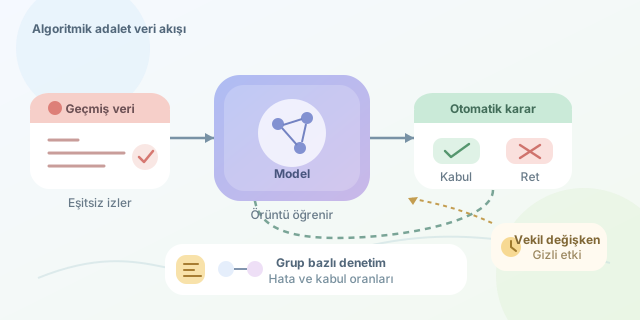
Bir algoritmanın ayrımcılık yapması için kötü niyetli bir geliştiriciye ihtiyacı yoktur. Çoğu zaman algoritma yalnızca geçmişte insanların verdiği kararları, toplumsal eşitsizlikleri ve görünmez kalıpları çok hızlı biçimde öğrenir. İşe alım sisteminden kredi puanına, yüz tanımadan içerik önerilerine kadar otomatik karar mekanizmaları; verinin içindeki sosyal izleri geleceğe taşıyabilir. Sorun, makinenin “önyargılı düşünmesi” değil, istatistiksel olarak başarılı görünürken tarihsel adaletsizlikleri yeniden üretmesidir.
``
Algoritma neden tarafsız değildir?
Makine öğrenmesi modelleri, bir hedefi tahmin etmek için geçmiş örneklerdeki düzenlilikleri bulur. Basitçe, modelin görevi şu şekilde ifade edilebilir:
\[\hat{y} = f(X; \theta)\]Burada $X$ özellikleri, $\theta$ modelin öğrendiği parametreleri, $\hat{y}$ ise tahmini temsil eder. Ancak eğitim verisindeki hedef değişken $y$, geçmiş insan kararlarıyla oluştuysa model yalnızca “başarıyı” değil, geçmişteki tercihleri de öğrenebilir. Örneğin geçmiş işe alımlarda belirli bir okul, mahalle veya isim grubu daha fazla seçildiyse, model bunları yetkinliğin dolaylı işaretleri sanabilir.
Bu durum özellikle vekil değişkenler (proxy variables) yüzünden sinsi hale gelir. Bir sistem cinsiyet veya etnik köken sütununu doğrudan kaldırsa bile posta kodu, okul adı, çalışma boşluğu ya da kullanılan dil gibi alanlar aynı sosyal bilgiyi dolaylı biçimde taşıyabilir. Yani “hassas alanı sildik, sorun çözüldü” yaklaşımı çoğu zaman bir güvenlik tiyatrosudur.
| Kavram | İnsan psikolojisindeki karşılığı | Algoritmadaki görünümü |
|---|---|---|
| Stereotip | Bir gruba ait genelleyici varsayım | Grup örüntüsünü bireye uygulama |
| Doğrulama yanlılığı | İnancı destekleyen örnekleri seçme | Yanlı etiketlerle eğitilme |
| Tarihsel eşitsizlik | Geçmiş fırsat farkları | Dengesiz eğitim verisi |
| Dolaylı ayrımcılık | Tarafsız görünen kuralın eşitsiz etkisi | Proxy değişken kullanımı |
“Doğru tahmin” her zaman adil karar değildir
Bir modelin genel doğruluğu yüksek olabilir; fakat hata oranları gruplar arasında ciddi biçimde değişebilir. İkili sınıflandırmada sık kullanılan ölçülerden biri doğru pozitif oranıdır:
\[TPR = \frac{TP}{TP + FN}\]Adil bir sistem tasarlarken yalnızca toplam doğruluğa değil, farklı gruplar için $TPR$, yanlış pozitif oranı ve reddedilme oranlarına da bakmak gerekir. Örneğin kredi başvurusunda iki grup için genel başarı yüzde 90 olabilir. Buna rağmen bir grup için uygun adayların yüzde 30’u yanlışlıkla reddediliyorsa, bu sistemin “başarılı” etiketi oldukça yanıltıcıdır.
| Yaklaşım | Avantajı | Riski |
|---|---|---|
| Sadece doğruluk optimizasyonu | Kolay ölçülür, hızlı uygulanır | Azınlık gruplarındaki hatayı gizler |
| Hassas veriyi kaldırma | İlk bakışta mahremiyet sağlar | Proxy değişkenleri engellemez |
| Grup bazlı adalet metrikleri | Eşitsiz hataları görünür kılar | Metrikler birbiriyle çelişebilir |
| İnsan denetimi | Bağlam ve itiraz imkânı sunar | İnsan ön yargısını geri getirebilir |
Veri boru hattında adalet kontrolü
Önyargı yalnızca model eğitilirken doğmaz. Problem tanımında, veri toplamada, etiketlemede, özellik seçiminde ve üretim sonrası izleme aşamasında ortaya çıkabilir. Bu nedenle adalet, modele sonradan eklenen bir filtre değil; tüm veri boru hattının tasarım ilkesi olmalıdır.
Aşağıdaki Python örneği, gruplara göre kabul oranını karşılaştıran basit bir denetim yapar. Amaç model kurmak değil, model çıktısının farklı grupları nasıl etkilediğini görünür hale getirmektir.
import pandas as pd

# approved: modelin kabul kararı, group: incelenen sosyal grup
df = pd.DataFrame({
    "group": ["A", "A", "A", "B", "B", "B"],
    "approved": [1, 1, 0, 1, 0, 0]
})

acceptance_rates = df.groupby("group")["approved"].mean()
print(acceptance_rates)

ratio = acceptance_rates["B"] / acceptance_rates["A"]
print(f"B/A kabul oranı: {ratio:.2f}")
Bu oran tek başına hüküm vermez; örneklem büyüklüğü, kullanım bağlamı ve yasal çerçeve de değerlendirilmelidir. Yine de “model herkes için aynı çalışıyor mu?” sorusunu somutlaştırır.
Sonuç olarak algoritmalar toplumu dışarıdan gözleyen nötr hakemler değildir. Toplumsal verilerle eğitildiklerinde, toplumun güçlü ve zayıf yanlarını matematiksel kalıplara dönüştürürler. Daha adil sistemler için şeffaf veri kaynakları, temsil gücü yüksek örneklemler, grup bazlı testler, itiraz mekanizmaları ve alan uzmanlarının denetimi gerekir. Kodun satır aralarında yalnızca mantık değil, toplumun geçmişi de bulunur.
Yorumlar