İçindekiler
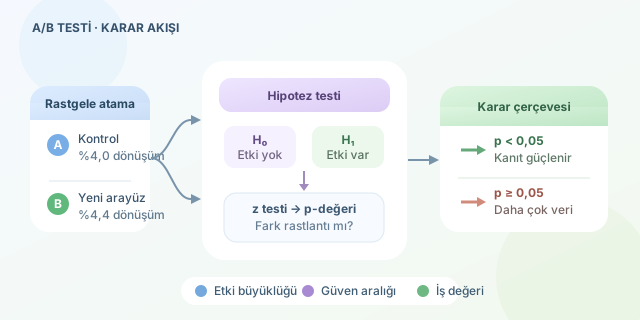
Yeni ödeme butonunu yeşile boyadınız ve dönüşüm oranı %4,0’dan %4,4’e çıktı. Tasarım ekibi kutlama hazırlığında, ürün yöneticisi ise sunuma roket emojileri ekliyor. Fakat durun: Bu artış gerçekten yeni arayüzden mi kaynaklandı, yoksa kullanıcıların rastlantısal davranışlarından mı? A/B testlerindeki p-değeri, tam olarak bu soruyu yanıtlamaya yardımcı olur.
``
A/B testinin temel mantığı
A/B testinde kullanıcılar rastgele iki gruba ayrılır:
- Kontrol grubu (A): Mevcut arayüzü görür.
- Deney grubu (B): Yeni arayüzü görür.
Ardından dönüşüm, tıklama veya oturum süresi gibi önceden belirlenmiş bir metrik karşılaştırılır. Rastgele atama; cihaz türü, kullanıcı deneyimi ve trafik kaynağı gibi dış etkenlerin iki gruba yaklaşık eşit dağılmasını amaçlar.
İstatistiksel test iki hipotezle başlar:
- $H_0$: Değişiklik metrik üzerinde gerçek bir etki yaratmamıştır.
- $H_1$: Değişiklik gerçek bir etki yaratmıştır.
Örneğin dönüşüm oranları için sıfır hipotezi $p_A=p_B$, alternatif hipotez ise iki yönlü bir testte $p_A\neq p_B$ şeklindedir.
| Kavram | Sorduğu soru | Yaygın yorum |
|---|---|---|
| P-değeri | $H_0$ doğruysa bu kadar uç bir sonuç ne kadar olası? | Küçüldükçe $H_0$ aleyhine kanıt artar |
| Anlamlılık düzeyi | Ne kadar yanlış alarm riskini kabul ediyoruz? | Genellikle $\alpha=0.05$ |
| Etki büyüklüğü | Değişiklik pratikte ne kadar fark yarattı? | İş hedefleriyle değerlendirilir |
| Güven aralığı | Gerçek etkinin makul aralığı nedir? | Belirsizliği görünür kılar |
Önemli bir düzeltme: P-değeri, sıfır hipotezinin doğru olma olasılığı değildir. Örneğin $p=0.03$, değişikliğin %97 olasılıkla başarılı olduğu anlamına gelmez. Yalnızca etki yokken gözlenen veya daha uç bir farkla karşılaşma olasılığının %3 olduğunu söyler.
İki dönüşüm oranını karşılaştırmak
A grubunda $n_A$ kullanıcıdan $x_A$, B grubunda ise $n_B$ kullanıcıdan $x_B$ kişi dönüşüm gerçekleştirsin:
\[\hat p_A=\frac{x_A}{n_A}, \qquad \hat p_B=\frac{x_B}{n_B}\]İki oranlı z-testinde ortak oran ve standart hata şöyle hesaplanır:
\[\hat p=\frac{x_A+x_B}{n_A+n_B}\] \[SE=\sqrt{\hat p(1-\hat p)\left(\frac{1}{n_A}+\frac{1}{n_B}\right)}\]Test istatistiği ise $z=(\hat p_B-\hat p_A)/SE$ olur. Z değeri standart normal dağılımda ne kadar uçtaysa p-değeri o kadar küçülür.
from statsmodels.stats.proportion import proportions_ztest

# A: 10.000 kullanıcıdan 400 dönüşüm
# B: 10.000 kullanıcıdan 440 dönüşüm
basarilar = [400, 440]
kullanicilar = [10_000, 10_000]

z_skoru, p_degeri = proportions_ztest(
    count=basarilar,
    nobs=kullanicilar,
    alternative="two-sided"
)

print(f"z skoru: {z_skoru:.3f}")
print(f"p-değeri: {p_degeri:.4f}")
Bu kod, iki grubun dönüşüm oranlarını iki yönlü z-testiyle karşılaştırır. Sonuç $p<0.05$ ise önceden belirlenen %5 anlamlılık düzeyinde $H_0$ reddedilebilir. Ancak bu karar, ürünün otomatik olarak yayına alınması gerektiğini göstermez.
İstatistiksel anlamlılık başarı demek değildir
%4,0’dan %4,4’e geçiş, göreli olarak $(4.4-4.0)/4.0=\%10$ artıştır. Bu ticari açıdan değerli olabilir; fakat sunucu maliyeti, kullanıcı memnuniyeti veya iade oranı kötüleşmişse toplam sonuç olumsuz kalabilir.
| Sonuç | P-değeri | Ürün kararı |
|---|---|---|
| Büyük ve anlamlı etki | Düşük | Yayına alma güçlü biçimde değerlendirilebilir |
| Küçük ama anlamlı etki | Düşük | Maliyet ve iş değeri incelenmelidir |
| Büyük ama anlamsız etki | Yüksek | Daha fazla örneklem gerekebilir |
| Küçük ve anlamsız etki | Yüksek | Değişiklik genellikle umut vermez |
En sık yapılan hatalar
Testi her saat kontrol edip anlamlı olduğu anda durdurmak yanlış pozitif riskini artırır. Örneklem büyüklüğü ve test süresi deneyden önce belirlenmelidir. Ayrıca onlarca metriği aynı anda sınamak, tesadüfen anlamlı sonuç bulmayı kolaylaştırır; Bonferroni veya yanlış keşif oranı düzeltmeleri gerekebilir.
Son olarak yalnızca p-değerini değil, etki büyüklüğünü, güven aralığını ve iş değerini birlikte raporlayın. İyi bir A/B testi sihirli bir onay düğmesi değil; rastlantıyla gerçek kullanıcı etkisi arasındaki sis perdesini incelten disiplinli bir karar aracıdır.
Yorumlar