Bir şehrin bütün köprülerinden yalnızca bir kez geçip yürüyüşü tamamlamak mümkün müdür? 18. yüzyılda Königsberg halkının merak ettiği bu soru, bugün graf teorisinin en meşhur problemlerinden biridir. Leonhard Euler’in çözümü yalnızca köprü bilmecesini açıklamakla kalmadı; ağlar, rotalar ve bağlantılar üzerine düşünme biçimimizi de değiştirdi.
Devamı...
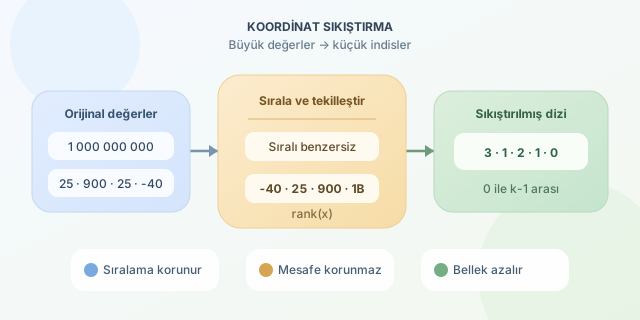
Bir milyara kadar uzanan koordinatlarınız olduğunu düşünün. Elinizde yalnızca birkaç bin nokta bulunmasına rağmen int dizi[1000000001] oluşturmak, küçük bir kargo için uçak kiralamaya benzer. Coordinate Compression, yani koordinat sıkıştırma, büyük fakat seyrek değerleri sıralarını koruyarak küçük indislerle temsil etmemizi sağlar. Böylece dev koordinatlar, standart diziler ve verimli veri yapılarıyla işlenebilir hâle gelir.
Devamı...
Bir partide herkesin iki gruptan yalnızca karşı gruptakilerle iletişim kurduğunu düşünün. Aynı gruptaki hiç kimse birbiriyle konuşmuyor! Kulağa biraz tuhaf gelse de bu düzen, graf teorisindeki bipartite graph, yani iki parçalı graf kavramını mükemmel biçimde anlatır. Üstelik bu graflar; eşleştirme, görev dağıtımı ve sosyal ağ analizi gibi birçok gerçek problemde karşımıza çıkar.
Devamı...
Bir algoritmanın bazı işlemleri aniden pahalılaşabilir. Dinamik bir dizi büyürken bütün elemanların kopyalanması veya bir sayaç artırılırken art arda birçok bitin değişmesi buna örnektir. Ancak tek bir kötü ana bakıp algoritmayı yavaş ilan etmek, ayda bir gelen yüklü market fişine bakarak her gün aynı harcamayı yaptığımızı sanmaya benzer. Amortized analysis, işlemleri tek tek değil, uzun bir işlem dizisi boyunca değerlendirir.
Devamı...
Bir algoritma günlük verilerde ışık hızında çalışabilir; fakat karşısına onun zayıf noktalarını bilen kurnaz bir rakip çıktığında bütün karizma dağılabilir. Adversarial analysis, girdilerin tesadüfen değil, algoritmayı mümkün olduğunca zorlamak amacıyla seçildiğini varsayar. Böylece “Genellikle hızlı mı?” sorusu yerine daha güvenli bir soru sorarız: “Onu sabote etmeye çalışan biri varken ne kadar iyi?”
Devamı...
Python, C veya JavaScript ile bir değişkeni artırmak tek satırlık iştir. Fakat işlemci; değişkenleri, döngüleri ya da fonksiyonları bizim anladığımız biçimde tanımaz. Onun dünyasında yazmaçlar, bellek adresleri ve son derece küçük komutlar vardır. x86 assembly öğrenmek, bilgisayarla onun ana diline yakın bir seviyede konuşmak ve yüksek seviye kodun perde arkasını görmek demektir.
Devamı...
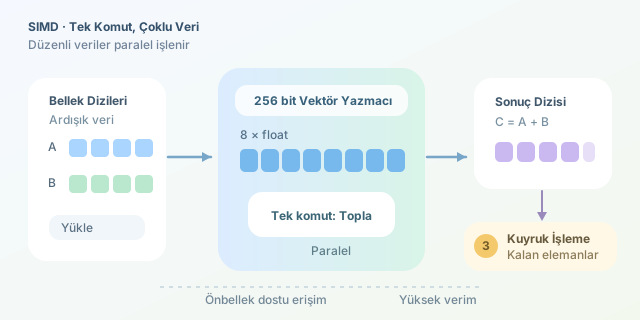
Bir dizideki milyonlarca sayıya aynı işlemi uyguladığınızı düşünün. Geleneksel yaklaşım, elemanları sırayla işlemekken SIMD komutları işlemciye “Bu işlemi tek sayı yerine bir grup sayı üzerinde gerçekleştir” der. Böylece hesaplamalar, süpermarket kasasında tek tek ürün geçirmek yerine bir sepeti aynı anda taramak gibi hızlanabilir.
Devamı...
Bir dil modeli cümleleri ustalıkla tamamlayabilir; ancak bu, verdiği yanıtların yararlı, güvenli veya insan beklentileriyle uyumlu olacağını garanti etmez. RLHF, yani Reinforcement Learning from Human Feedback, modelin yalnızca “sonraki kelime ne olmalı?” sorusuna değil, “insanlar hangi yanıtı tercih eder?” sorusuna da odaklanmasını sağlayan bir eğitim yaklaşımıdır.
Devamı...
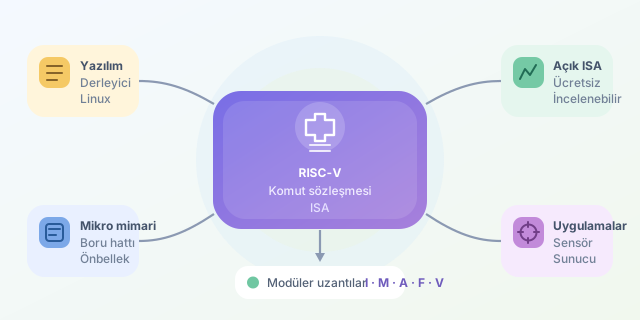
Bir işlemcinin hangi komutları anlayacağını hiç merak ettiniz mi? Yazılım ile silikon arasındaki bu sözleşme, komut kümesi mimarisi yani ISA olarak adlandırılır. RISC-V, herkesin inceleyebildiği ve lisans ücreti ödemeden kullanabildiği açık bir ISA sunarak işlemci dünyasındaki yerleşik düzeni değiştiriyor. Üniversite laboratuvarından veri merkezlerine uzanan bu yükseliş, yalnızca teknik değil, ekonomik bir dönüşümü de temsil ediyor.
Devamı...
Bir sahneyi gerçekçi göstermek istiyorsanız yalnızca nesneleri çizmek yetmez; ışığın dünyada nasıl davrandığını da düşünmeniz gerekir. Ray tracing, yani ışın izleme, tam olarak bunu yapar: Kameradan hayali ışınlar gönderir, bu ışınların nesnelerle karşılaşmasını hesaplar ve her pikselin rengini belirler. Kısacası yöntem, dijital bir sahnede ışığa dedektif şapkası takar.
Devamı...
Bir dil modeline “yalnızca JSON üret” dediğinizde çoğu zaman JSON alırsınız; ama bazen model açıklama ekler, biçimi bozar veya hiç beklemediğiniz bir cevap verir. Prompt mühendisliği, model davranışını sihirli sözcüklerle kesin olarak programlamak değil, olasılıkları istenen yöne doğru itmektir. Bu ayrım önemlidir: Prompt bir sözleşmeye benzese de geleneksel programlama dilindeki katı bir komut değildir.
Devamı...
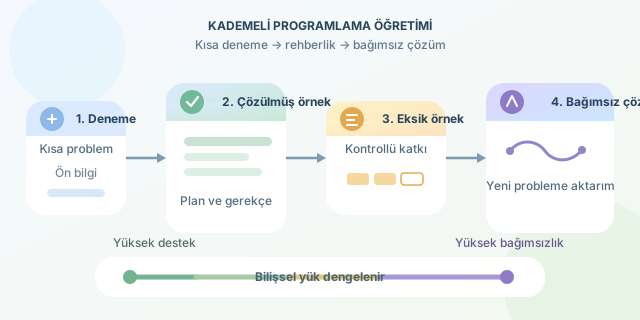
Programlama öğrenirken doğrudan boş bir editörle karşılaşmak bazen yüzme bilmeden havuza atılmaya benzer. Öğrenci problemi, sözdizimini, algoritmayı ve hata mesajlarını aynı anda yönetmeye çalışır. Worked example, yani adım adım açıklanmış çözülmüş örnek yaklaşımı, bu yükü azaltmayı amaçlar. Peki öğrenciye önce çözüm mü gösterilmeli, yoksa düşünmesi için önce problem mi verilmelidir?
Devamı...
Bir oyun dünyasını kare kare elle tasarlamak romantik görünebilir; ta ki milyonuncu ağacı yerleştirmeniz gerekene kadar! Prosedürel üretim, içeriği önceden saklamak yerine matematiksel kurallarla ihtiyaç anında oluşturur. Perlin gürültüsü ise rastgeleliğin kaotik görüntüsünü yumuşatarak dağlar, vadiler, adalar ve biyomlar üretmemizi sağlayan en kullanışlı araçlardan biridir.
Devamı...
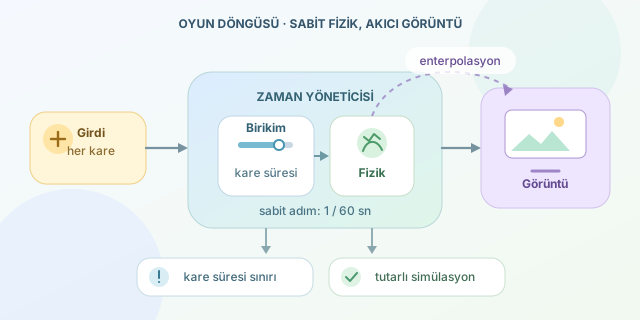
Bir oyun çalışırken ekrandaki karakterler hareket eder, fizik hesaplanır, oyuncu girdileri okunur ve görüntü yeniden çizilir. Bütün bu işleri durmaksızın yöneten yapıya oyun döngüsü, yani game loop denir. Ancak ekran kartı saniyede 144 kare üretirken fiziğin aynı hızda güncellenmesi oyunu farklı bilgisayarlarda tutarsızlaştırabilir. Sağlam bir mimarinin sırrı, görüntüleme ile simülasyonu birbirinden ayırmaktır.
Devamı...
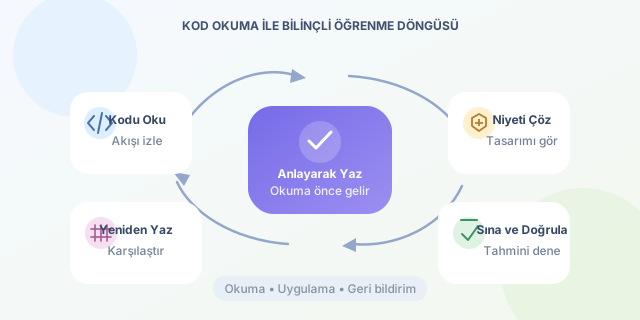
Programlama öğrenirken verilen ilk öğüt genellikle “Bol bol kod yaz” olur. Elbette klavyeyle arayı iyi tutmak önemlidir; fakat yalnızca kod yazarak ilerlemek, konuşmayı öğrenmek için sürekli monolog yapmaya benzer. Başkalarının kodlarını okumak ise farklı kelimeleri, anlatım biçimlerini ve problem çözme yollarını görmemizi sağlar. Bu nedenle kod okumanın kod yazmaktan önce gelmesi gerektiği fikri, tartışılmayı hak eden güçlü bir yaklaşımdır.
Devamı...
Bir işlemcinin saniyede milyarlarca komut çalıştırabilmesi etkileyicidir; fakat ihtiyaç duyduğu veriyi beklerken hiçbir şey yapamaması pek havalı değildir. Modern bilgisayarlarda L1, L2 ve L3 önbelleklerin bulunmasının temel nedeni bu beklemeyi azaltmaktır. Veriler işlemci çekirdeğinden uzaklaştıkça erişim süresi artar; kapasite büyürken hız katman katman düşer.
Devamı...
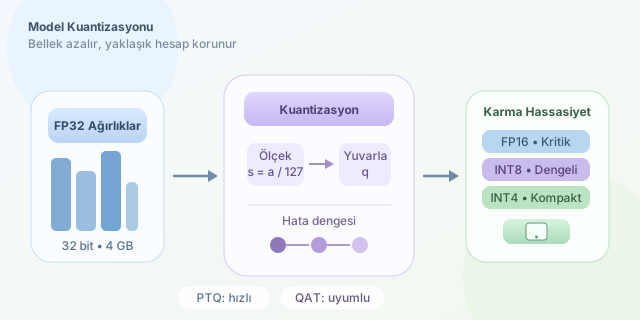
Bir yapay zekâ modelini telefonda çalıştırmak, taşınma günü dev bir koltuğu küçücük asansöre sokmaya benzer. Modelin milyarlarca parametresi belleği doldurur, hesaplamaları yavaşlatır ve pili neşeyle tüketir. Model kuantizasyonu, bu sayıları daha az bit kullanarak temsil eder; yani koltuğu parçalamadan, daha kompakt hâle getirir. Üstelik doğru uygulandığında modelin yeteneklerinin çoğu korunur.
Devamı...
Büyük bir restoranda her yemeği tek aşçının hazırladığını düşünün. Aşçı yetenekli olsa bile suşiden tatlıya kadar her konuda aynı derecede başarılı olması zordur. Mixture of Experts (MoE) mimarisi de benzer bir problemi çözer: Tek ve devasa bir sinir ağı yerine, farklı girdilerde uzmanlaşabilen alt ağlar kullanır. Üstelik her girdi bütün uzmanlara gönderilmez; bir yönlendirici, o girdi için en uygun birkaç uzmanı seçer.
Devamı...
Milyarlarca parametreye sahip bir dil modelini kendi verilerimizle eğitmek kulağa pahalı ekran kartlarıyla dolu bir veri merkezi gerektiriyormuş gibi gelebilir. LoRA, yani Low-Rank Adaptation, modelin tamamını değiştirmek yerine küçük ve eğitilebilir ek matrisler kullanarak bu maliyeti ciddi biçimde azaltır. Böylece tek bir güçlü tüketici ekran kartıyla bile alan odaklı modeller geliştirmek mümkün hâle gelir.
Devamı...
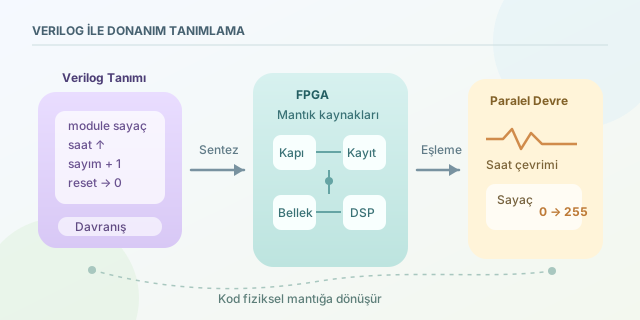
Bir işlemcinin komutları sırayla çalıştırmasına alışkınsanız, FPGA dünyası ilk bakışta biraz büyülü görünebilir. Verilog ile birkaç satır yazıyor, ardından kabloların, mantık kapılarının ve register’ların gerçekten oluşmasını sağlıyorsunuz. Ancak burada önemli bir ayrım var: Verilog, klasik anlamda donanıma ne yapacağını söyleyen bir yazılım dili değil; donanımın nasıl davranacağını ve bağlanacağını tanımlayan bir donanım tanımlama dilidir.
Devamı...