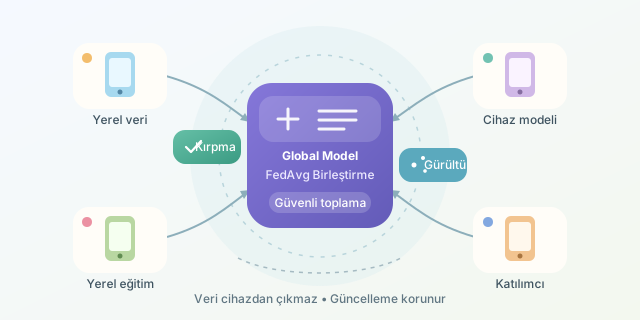
Telefonunuzun yazdığınız kelimeleri tahmin etmeyi öğrendiğini, ancak mesajlarınızın hiçbir zaman merkezi bir sunucuya gönderilmediğini düşünün. Federated Learning, yani federe öğrenme, tam olarak bu fikri hayata geçirir: Veriyi modele taşımak yerine modeli veriye götürür. Diferansiyel gizlilik ise paylaşılan model güncellemelerinden kişisel bilgilerin çıkarılmasını matematiksel olarak zorlaştırır.
Devamı...
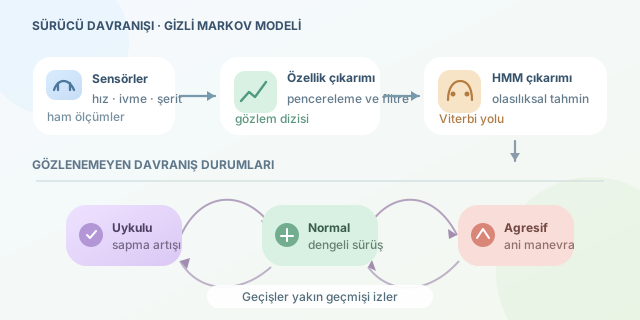
Bir otomobil sürücünün zihnini okuyamaz; ancak direksiyon hareketlerini, hız değişimlerini ve frenleme biçimini dikkatle dinleyebilir. Hidden Markov Modeli (HMM), doğrudan göremediğimiz uykulu, agresif veya normal sürüş durumlarını sensörlerden gelen ölçümler yardımıyla tahmin eder. Kısacası HMM, aracın küçük ipuçlarından sürücünün perde arkasındaki durumunu anlamaya çalışan istatistiksel bir dedektiftir.
Devamı...
Bir televizyonun çekmediği kanaldaki karıncalanmayı düşünün. Şimdi bu rastgele piksellerin yavaşça bir kediye, uzay gemisine veya Van Gogh esintili bir manzaraya dönüştüğünü hayal edin. Denoising Diffusion Probabilistic Models, yani DDPM, tam olarak bunu yapar: Veriyi kontrollü biçimde gürültüye dönüştürmeyi öğrenir ve ardından zamanı tersine sararak gürültüden yeni görüntüler üretir.
Devamı...
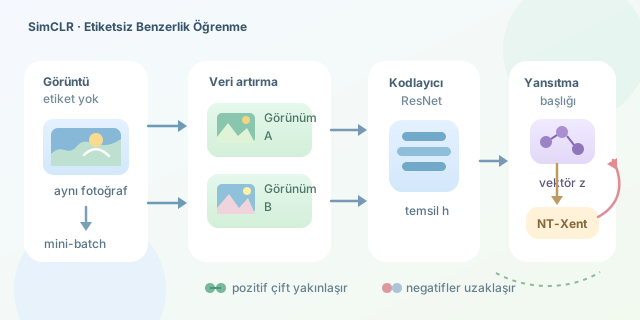
Bir makineye binlerce kedi fotoğrafı gösterdiğinizi, fakat hiçbirine “kedi” etiketi koymadığınızı düşünün. Makine yine de kulak, tüy ve yüz şekli gibi ortak özellikleri keşfedebilir mi? Contrastive Learning, yani karşılaştırmalı öğrenme, tam olarak bunu hedefler: Benzer örnekleri temsil uzayında birbirine yaklaştırır, farklı örnekleri ise uzaklaştırır. SimCLR da bu fikri şaşırtıcı derecede sade bir eğitim düzenine dönüştüren popüler yöntemlerden biridir.
Devamı...
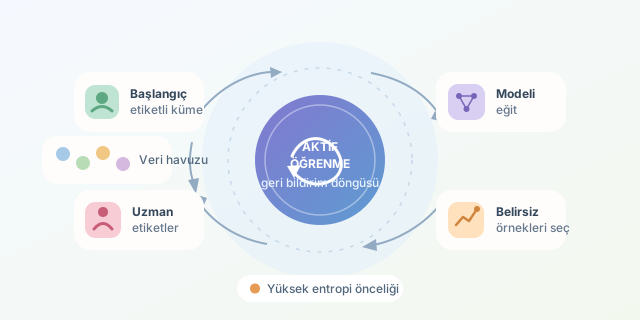
Elinizde milyonlarca kedi, köpek ve muhtemelen ne olduğu yalnızca biyologların anlayabileceği canlı fotoğrafı olduğunu düşünün. Bunların hepsini insanlara etiketletmek pahalı ve yavaştır. Active Learning, yani aktif öğrenme, modelin kalabalığın içinden öğrenmeye en çok katkı sağlayacak örnekleri seçip uzmana “Şuna bir bakar mısın?” demesidir.
Devamı...
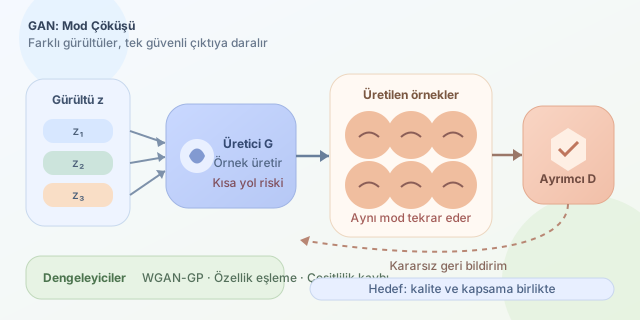
Bir GAN’dan bin farklı insan yüzü üretmesini beklersiniz; model ise aynı kişiye yalnızca farklı şapkalar takıp karşınıza çıkarır. Tebrikler, üreticiniz yaratıcı bir sanatçı olmak yerine tek numarası olan bir illüzyoniste dönüşmüştür! Mode collapse, üretici modelin veri dağılımındaki çeşitliliği öğrenmek yerine ayrımcıyı kandıran birkaç güvenli çıktıya saplanmasıdır.
Devamı...
Bir yapay zekâdan daha önce var olmamış bir yüz, ürün tasarımı veya el yazısı rakam üretmesini istediğimizde perde arkasında ilginç bir soru belirir: Model, verinin dünyasını nasıl öğrenmelidir? VAE bu dünyayı düzenli bir olasılık haritasına dönüştürmeye çalışırken GAN, bir sahtekâr ile dedektifi karşı karşıya getirir. İkisi de sentetik veri üretir; fakat gerçekliğe ulaşma felsefeleri oldukça farklıdır.
Devamı...
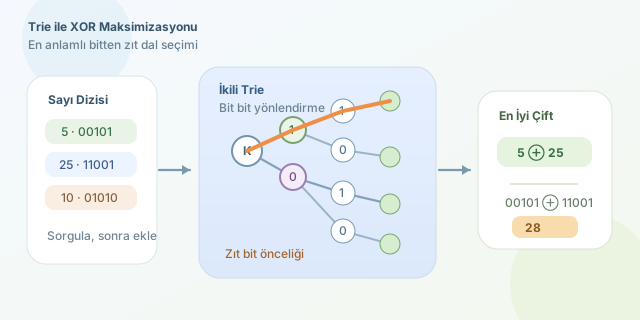
Bir sayı dizisindeki iki elemanın XOR sonucunu en büyük yapmak, ilk bakışta bütün çiftleri denemeyi gerektiren yorucu bir problem gibi görünür. Ancak sayıları bit dizileri olarak ele alıp bir ikili Trie içine yerleştirdiğimizde, her sayı için en iyi eşleşmeyi bit bit seçebiliriz. Böylece kaba kuvvetin karesel maliyetinden kurtulup oldukça hızlı ve eğlenceli bir çözüme ulaşırız.
Devamı...
Transformer modelleri cümledeki kelimeler arasındaki ilişkileri dikkat mekanizmasıyla başarıyla yakalar. Ancak küçük bir sorun vardır: Saf attention işlemi, kelimelerin hangi sırada geldiğini doğal olarak bilmez. Yani model için “Kedi fareyi kovaladı” ile “Fare kediyi kovaladı” başlangıçta aynı kelime koleksiyonu gibi görünebilir. Positional encoding, modele kelimelerin cümledeki konumlarını matematiksel bir pusulayla göstererek bu problemi çözer.
Devamı...
Düzlemde yüzlerce dikdörtgen bulunduğunu ve en az iki dikdörtgen tarafından kaplanan toplam alanı hesaplamamız gerektiğini düşünelim. Her dikdörtgen çiftini ayrı ayrı incelemek cazip görünür; ancak üçlü kesişimler aynı alanı defalarca saydırabilir. Tarama çizgisi, iki boyutlu bu karmaşayı dikey bir çizgiyi soldan sağa kaydırarak tek boyutlu aralık problemlerine dönüştürür.
Devamı...
Bir yapay zekâ modeline milyonlarca kedi fotoğrafı gösterip her birine “Bu bir kedidir” etiketi eklemek oldukça yorucudur. Peki model, etiketleri insanlardan beklemek yerine verinin içindeki ipuçlarından kendisi üretebilseydi? Self-Supervised Learning (öz-denetimli öğrenme), tam olarak bunu yapar: Ham veriyi hem soru hem de cevap anahtarı olarak kullanır.
Devamı...
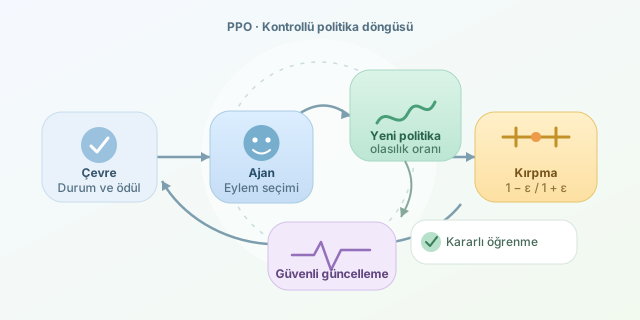
Bir robotun yürümeyi öğrendiğini düşünün. İlk denemelerinde düşmesi normaldir; ancak sonunda iki adım atmayı başardığında bütün hareket politikasını bir anda değiştirmesi pek akıllıca olmaz. Belki üçüncü adımı atayım derken yeniden takla atacaktır! Proximal Policy Optimization, yani PPO, bir ajanın politikasını geliştirirken bu tür aşırı güncellemeleri sınırlayan popüler bir reinforcement learning algoritmasıdır.
Devamı...
Bir diziyi güncelledikten sonra eski değerlerine yeniden ihtiyaç duyduğunuzu düşünün. Normal bir Segment Tree değişiklikleri doğrudan mevcut yapı üzerinde uygular; geçmiş ise sessizce kaybolur. Persistent Segment Tree, her güncellemede yeni bir sürüm oluşturarak bu sorunu çözer. Üstelik bütün ağacı kopyalamak yerine yalnızca değişen düğümleri üretir. Kısacası elimizde veri yapılarının zaman makinesi vardır!
Devamı...
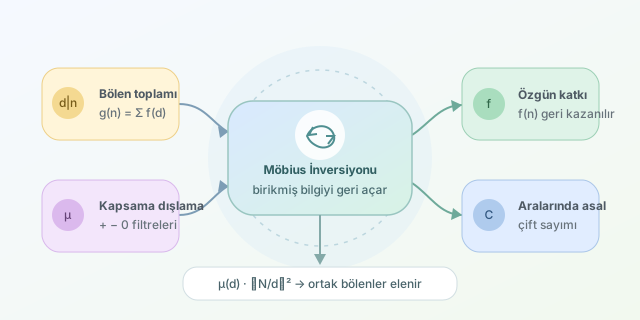
Bazı sayılar teorisi problemleri, bölenlerin ve ortak çarpanların iç içe geçmesi yüzünden çözülmez bir düğüm gibi görünür. Möbius inversiyonu ise bu düğümü tek tek açmak yerine matematiksel olarak tersine çevirir. Aralarında asal çiftleri saymaktan bölen toplamlarından özgün bir fonksiyonu geri kazanmaya kadar pek çok işlem, böylece zarif bir kapsama-dışlama hesabına dönüşür.
Devamı...
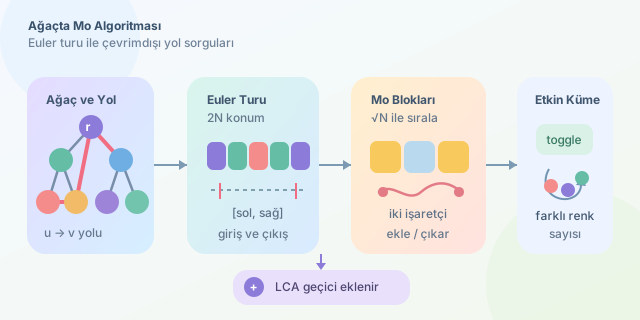
Bir dizideki aralık sorgularını akıllıca sıralayıp tekrar kullanılabilir hesaplarla hızlandıran Mo algoritması, küçük bir Euler turu numarasıyla ağaçlarda da çalışabilir. Özellikle iki düğüm arasındaki yolda kaç farklı renk bulunduğu gibi sorgular, ağacı doğrusal bir yapıya dönüştürdüğümüzde bloklar hâlinde işlenebilir.
Devamı...
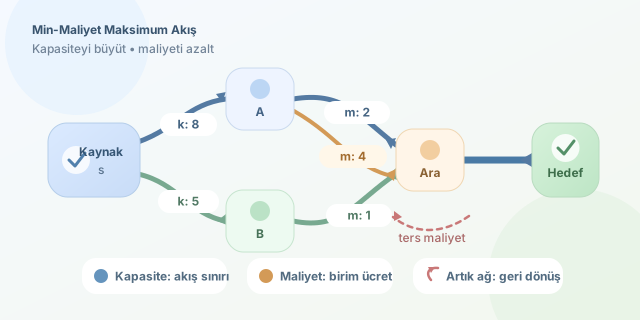
Bir lojistik ağında mümkün olan en fazla ürünü taşımak yetmez; bunu hangi maliyetle yaptığınız da önemlidir. Min-Cost Max-Flow (MCMF), kaynaktan hedefe maksimum akışı gönderirken toplam taşıma maliyetini en aza indiren algoritma ailesidir. Kısacası maksimum performans ile minimum fatura arasında matematiksel bir barış anlaşması imzalar.
Devamı...
Fibonacci dizisinin milyonuncu, hatta milyarıncı terimini hesaplamak istediğimizi düşünelim. Diziyi baştan sona üretmek kolaydır; fakat bilgisayara milyarlarca kez toplama yaptırmak, çay demlenirken başlayıp yeni bir çay plantasyonu kurulunca biten bir plan olabilir. Neyse ki doğrusal tekrarlamaları matris biçiminde ifade ederek problemi $O(n)$ zamandan $O(\log n)$ zamana indirebiliriz.
Devamı...
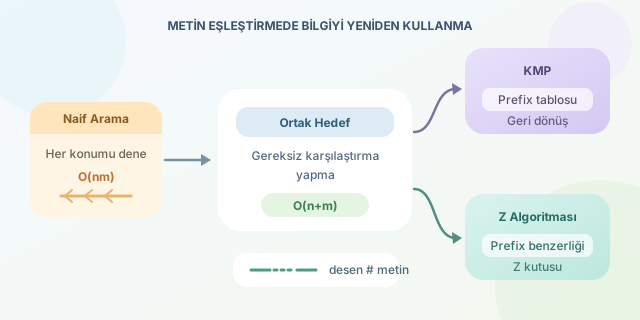
Bir metnin içinde desen aramak ilk bakışta basittir: Her konumu dene, karakterleri karşılaştır ve eşleşme bozulunca ilerle. Ancak uzun metinlerde bu yaklaşım pahalılaşır. KMP ve Z-algoritması aynı sorunu doğrusal zamanda çözer; buna rağmen Z dizisi, daha sezgisel tanımı ve farklı problemlere kolay uyarlanması sayesinde kimi zaman KMP’nin meşhur prefix tablosundan daha zarif bir araçtır.
Devamı...
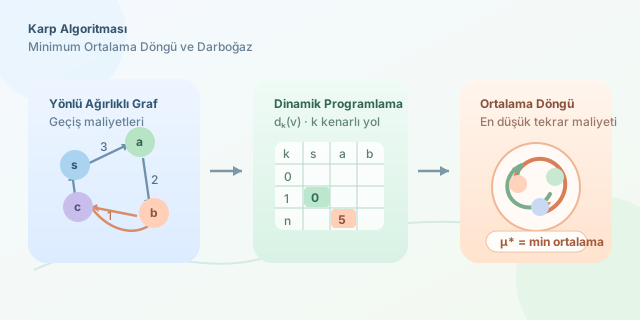
Bir üretim hattı, işlemci görev zinciri veya ağ yönlendirme sistemi düşünün: İşler belirli durumlar arasında sürekli dolaşıyor ve her geçişin bir maliyeti var. Sistemin uzun vadeli sınırını çoğu zaman tek bir pahalı kenar değil, tekrar tekrar kullanılan bir döngünün ortalama maliyeti belirler. Richard Karp’ın minimum ortalama döngü algoritması, tam olarak bu gizli darboğazı polinom zamanda ortaya çıkarır.
Devamı...
Bir sosyal ağı yalnızca “kim kimi takip ediyor?” sorusuyla incelemek, kalabalık bir partide sadece tokalaşmaları saymaya benzer. Oysa arkadaş grupları, ilgi toplulukları ve etkileşim çevreleri bağlantıların oluşturduğu daha büyük desenlerde saklıdır. Graph Neural Networks (GNN), düğüm özellikleriyle ağ yapısını birlikte öğrenerek bu gizli toplulukları ortaya çıkarabilir.
Devamı...